Crawling Nedir? Arama Motorları Web Sayfalarını Nasıl Tarar?
27 Eylül 2026 · Berke Dalar
SEO 101 · DERS 05
MODÜL: SEARCH SİSTEMİ
Crawling veya Türkçede tarama, bir arama motoru crawler’ının bildiği URL’lere erişerek sayfalardaki içeriği getirmesi sürecidir. Google Search tarafında bu işi yapan crawler’ların en bilineni Googlebot’tur. Crawler URL’ye bir istek gönderir, sunucudan cevap alır ve erişebildiği içeriği sonraki Search işlemlerinde kullanılmak üzere sisteme taşır.
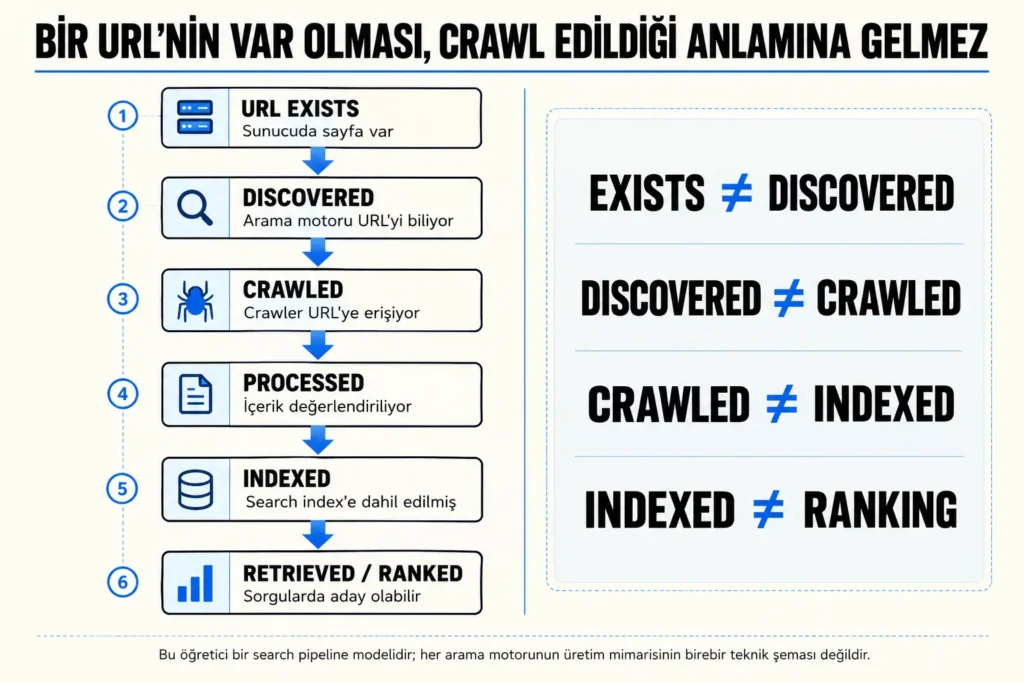
Buradaki en önemli ayrım şudur: bir URL’nin internette var olması, Google tarafından bilinmesi, crawl edilmesi, indexlenmesi ve arama sonuçlarında görünmesi aynı olay değildir. Crawling bu zincirin yalnız bir aşamasıdır.
URL EXISTS
↓
DISCOVERED
↓
CRAWLED
↓
INDEXED
↓
RETRIEVED / RANKED
Bu nedenle Crawled ≠ Indexed ve Indexed ≠ Ranking ayrımlarını daha crawling kavramını öğrenirken kurmak gerekir.
Crawling ne demektir?
Web crawling, crawler, bot veya spider olarak adlandırılan otomatik yazılımların URL’lere erişerek içerikleri alması sürecidir. Arama motorları web üzerindeki bütün sayfaların hazır bir listesini kullanmaz; yeni veya güncellenmiş URL’leri keşfetmeleri ve gerektiğinde tekrar ziyaret etmeleri gerekir.
Google crawling aşamasını, otomatik programların internette bulunan sayfalardaki metin, görsel ve video gibi içerikleri indirdiği Search aşaması olarak açıklar. Fakat crawling’in görevi içeriğin arama sonuçlarında mutlaka gösterilmesine karar vermek değildir. Önce içeriğe erişilir; indexing ve sonraki değerlendirmeler ayrı aşamalarda gerçekleşir.
KNOWN URL
↓
CRAWLER
↓
HTTP REQUEST
↓
SERVER
↓
HTTP RESPONSE
↓
CONTENT
Bu basit model bize crawler’ın bir kullanıcı gibi siteyi ekranda açıp gezmek zorunda olmadığını gösterir. Temelde URL’ler ve sunucudan alınan cevaplar üzerinden çalışan otomatik bir sistemden bahsediyoruz.
Crawler, bot ve spider nedir?
Crawler, bot, robot ve spider kelimeleri SEO konuşmalarında çoğu zaman web üzerinde otomatik olarak URL’lere erişen yazılımlar için kullanılır. Google Search’ün crawling sistemi söz konusu olduğunda karşımıza çıkan temel isim Googlebottur.
Ancak internette gördüğün her bot Googlebot değildir. Arama motorları dışında monitoring sistemleri, SEO araçları, scraping yazılımları ve başka otomatik servisler de sitelere istek gönderebilir. Bu nedenle “siteyi bir bot ziyaret etti” ile “Google bu sayfayı crawl etti” aynı gözlem değildir.
Discovery ile crawling arasındaki fark nedir?
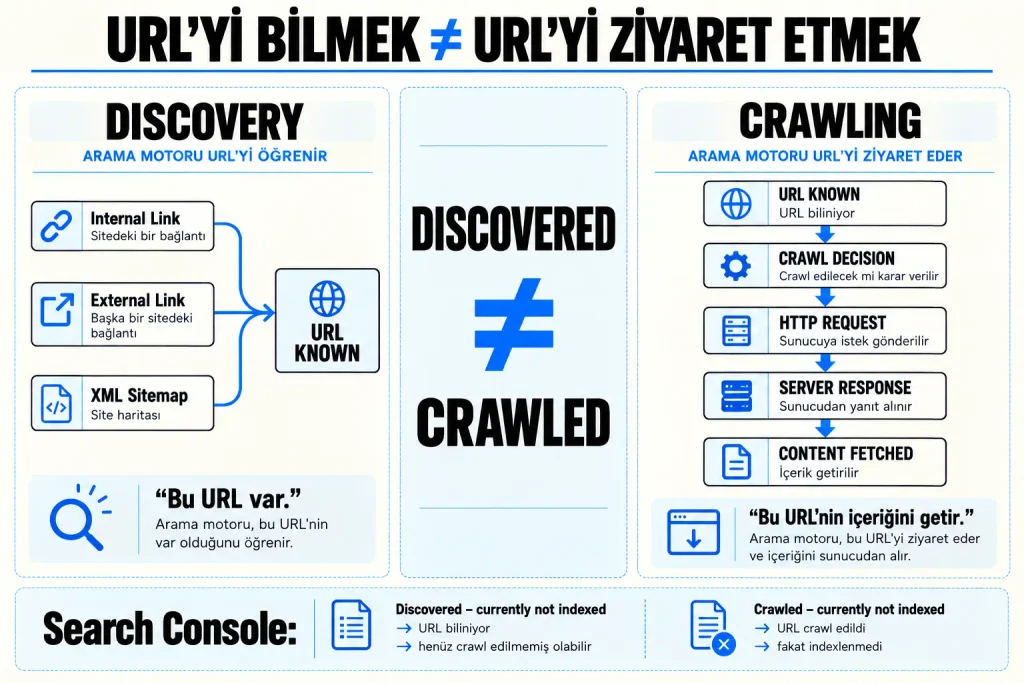
Discovery, arama motorunun bir URL’nin varlığından haberdar olmasıdır. Crawling ise bilinen URL’ye crawler’ın gerçekten erişmesidir. Bu iki aşama birbirini takip edebilir ama aynı şey değildir.
DISCOVERY

"Bu URL var."


CRAWLING

"Bu URL'ye erişip içeriği getireyim."
Örneğin yeni bir yazı yayınladığını düşünelim:
https://example.com/yeni-yazi/Bu URL’ye mevcut bir yazıdan internal link vermen veya URL’yi XML sitemap içinde belirtmen, arama motorunun URL’yi keşfetmesine yardımcı olabilir. Fakat arama motorunun URL’den haberdar olması, aynı anda sayfayı crawl ettiği anlamına gelmez.
| Aşama | Temel soru |
|---|---|
| URL exists | Sayfa internette gerçekten var mı? |
| Discovered | Arama motoru bu URL’nin varlığını biliyor mu? |
| Crawled | Crawler URL’ye erişip içeriği aldı mı? |
| Indexed | İçerik Search index’e dahil edildi mi? |
Dolayısıyla:
URL EXISTS ≠ DISCOVERED
DISCOVERED ≠ CRAWLED
CRAWLED ≠ INDEXED
SEO’da çok sayıda yanlış teşhis bu aşamaların birbirine karıştırılmasıyla başlar.
Arama motorları yeni URL’leri nasıl keşfeder?
Arama motorları yeni URL’leri farklı kaynaklardan öğrenebilir. En temel kaynaklardan biri, daha önce bildikleri sayfalarda bulunan bağlantılardır. Crawler bilinen bir sayfayı işlerken oradaki bağlantıları görebilir ve daha önce bilmediği yeni URL’leri keşfedebilir.
KNOWN PAGE
↓
LINK
↓
NEW URL
↓
DISCOVERY
Bu bağlantı site içerisindeki başka bir sayfadan gelebileceği gibi başka bir web sitesinden de gelebilir. XML sitemap de site sahibinin önemli gördüğü URL’leri arama motorlarına bildirmesine yardımcı olan ayrı bir discovery kaynağıdır.
Bu nedenle internal linking yalnız kullanıcıların sitede gezinmesi veya sayfalar arasında “SEO gücü” aktarması açısından düşünülmemelidir. Bağlantılar aynı zamanda web üzerindeki URL ilişkilerinin keşfedilmesine yardımcı olur.
XML sitemap crawling garantisi verir mi?
Hayır. XML sitemap, arama motorlarına sitedeki önemli URL’ler hakkında bilgi vermeye yardımcı olur. Google özellikle büyük, yeni veya internal linking yapısı zayıf sitelerde sitemap’in URL discovery açısından yararlı olabileceğini belirtir.
Ancak sitemap içinde bir URL bulunması, Google’ın URL’yi kesinlikle crawl edeceği veya indexleyeceği anlamına gelmez.
SITEMAP
↓
URL DISCOVERY'Yİ DESTEKLER

ama

SITEMAP
≠
CRAWLING GARANTİSİ
≠
INDEXING GARANTİSİ
Bu ayrım önemlidir çünkü yeni başlayan biri çoğu zaman “URL sitemap’te, neden Google’da yok?” diye düşünür. Sitemap yalnız search pipeline’ın erken aşamalarından birine yardımcı olabilir; sonraki bütün kararları ortadan kaldırmaz.
Googlebot bir sayfayı crawl ederken ne olur?
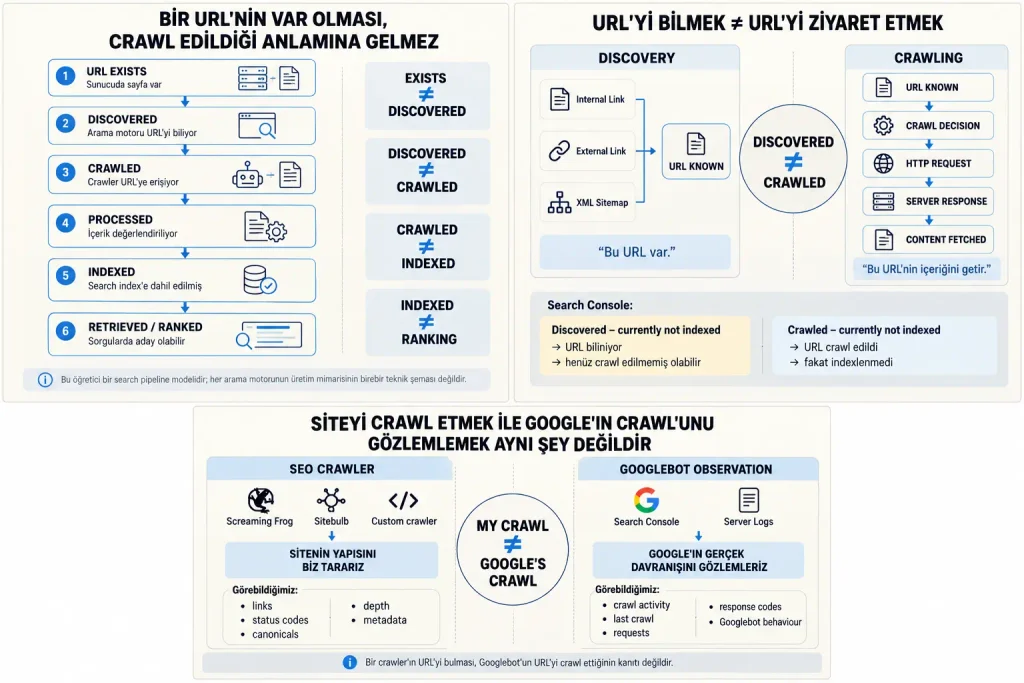
Googlebot bilinen bir URL’yi crawl etmeye karar verdiğinde sunucuya HTTP isteği gönderir. Sunucu bu isteğe bir response ile cevap verir ve crawler erişebildiği içeriği alır.
URL
↓
GOOGLEBOT
↓
HTTP REQUEST
↓
WEB SERVER
↓
HTTP RESPONSE
↓
CONTENT FETCHED
Bu nedenle crawling yalnız “Google sayfaya geldi” şeklinde soyut bir kavram değildir. Arka planda gerçek bir istemci-sunucu iletişimi vardır. Sayfanın çalışmaması, sunucunun cevap vermemesi veya crawler’ın içeriğe erişememesi bu süreci etkileyebilir.
Ancak bunların ayrıntılı teknik teşhisi beginner crawling dersinin konusu değildir. Bir URL’nin neden crawl edilemediğini, robots.txt, HTTP durumları, noindex ve diğer teknik sinyallerle birlikte incelemek için crawlability ve indexability arasındaki farkı anlattığım ileri rehbere geçebilirsin.
Crawling ile indexing arasındaki fark nedir?
Crawling, crawler’ın URL’ye erişip içeriği getirmesiyle ilgilidir. Indexing ise erişilen içeriğin analiz edilmesi ve arama sırasında kullanılabilecek yapılara dahil edilip edilmeyeceğinin değerlendirilmesidir.
| Crawling | Indexing | |
|---|---|---|
| Temel soru | Crawler içeriğe erişti mi? | İçerik Search index’e dahil edildi mi? |
| Basit aktör | Crawler / Googlebot | Indexing sistemleri |
| Sonuç | İçerik getirilebilir. | İçerik aranabilir yapılara dahil edilebilir. |
Google’ın bir sayfayı crawl etmiş olması, o sayfayı mutlaka indexleyeceği anlamına gelmez. Google da Search’ün crawling, indexing ve sonuçları sunma aşamalarından oluştuğunu ve bütün sayfaların her aşamadan geçmesinin garanti edilmediğini açıkça belirtir.
CRAWLED
≠
INDEXED
Indexing’in kendi mekanizmasını bir sonraki SEO 101 dersinde ayrı olarak inceleyeceğiz. Search pipeline’ın tamamını birlikte görmek için ise arama motorlarının nasıl çalıştığını anlatan ana rehberi okuyabilirsin.
Bir sayfanın crawl edilmesi neden önemlidir?
Arama motorunun bir sayfanın içeriğini değerlendirebilmesi için genellikle önce içeriğe erişebilmesi gerekir. Crawler sayfanın içeriğini alamıyorsa arama sisteminin sayfa hakkında kullanabileceği bilgi de sınırlı kalır.
Fakat buradan “daha fazla crawling = daha iyi SEO” sonucu çıkarılmamalıdır. Crawling search pipeline’ın erken aşamalarından biridir; ranking ise daha sonraki bir problemdir.
MORE CRAWLING
≠
HIGHER RANKING
Googlebot’un bir sayfayı sık ziyaret etmesi tek başına sayfanın daha yüksek sıralama alacağını göstermez. Önce crawling’i ranking metriği değil, arama sisteminin içeriğe erişebilmesini sağlayan bir süreç olarak düşünmek gerekir.
Internal linkler crawling açısından neden önemlidir?
Bir crawler daha önce bildiği sayfalardaki bağlantıları izleyerek yeni URL’ler keşfedebilir. Bu nedenle önemli bir sayfanın sitedeki diğer anlamlı sayfalarla bağlantılı olması yalnız kullanıcı deneyimi açısından değil, URL discovery açısından da önemlidir.
Örneğin bir e-ticaret sitesine yeni kategori eklediğini düşün:
ANA KATEGORİ
↓
ALT KATEGORİ
↓
YENİ KATEGORİ SAYFASI
Bu yapı hem kullanıcıya kategoriler arasındaki ilişkiyi gösterir hem de crawler’a yeni URL’ye ulaşabileceği doğal bir yol sağlar.
Buna karşılık sitenin hiçbir yerinden link almayan bir URL teknik olarak mevcut olabilir fakat sitenin gerçek link yapısında görünmez durumda kalabilir. Sitemap farklı bir discovery yolu sağlayabilir, ancak site mimarisindeki bağlantı ilişkisini tamamen ikame etmez.
Crawling ile crawlability aynı şey midir?
Tam olarak değil. Crawling gerçekleşen sürecin kendisidir; crawlability ise crawler’ın URL’ye erişip içeriği getirebilme durumunu anlatır.
CRAWLING
= süreç

CRAWLABILITY
= bu sürecin gerçekleşebilmesine ilişkin durum
Örneğin bir URL teknik olarak crawlable olabilir fakat Google henüz o URL’yi crawl etmemiş olabilir. Bu yüzden “Google crawl edebilir” ile “Google crawl etti” aynı cümle değildir.
Crawlability, indexability ve gerçek indexing durumlarının nasıl ayrıldığını Crawlability ve Indexability Nedir? rehberinde teknik teşhis seviyesinde ele alıyorum.
Junior’ın crawling konusunda en sık yaptığı hatalar
| Yanlış yorum | Daha doğru model |
|---|---|
| URL yayında, Google biliyordur. | URL exists ≠ discovered. |
| Google URL’yi biliyorsa crawl etmiştir. | Discovered ≠ crawled. |
| Crawl edildiyse indexlenir. | Crawled ≠ indexed. |
| Sitemap’te varsa mutlaka crawl edilir. | Sitemap discovery’yi destekler; garanti vermez. |
| Daha sık crawl daha iyi ranking demektir. | Crawling ve ranking farklı Search aşamalarıdır. |
Bu ayrımları oturtmak, ileride Search Console’da gördüğün durumları veya technical SEO problemlerini doğru katmana yerleştirmeni kolaylaştırır.
Basit bir crawling örneği
Yeni bir blog yazısı yayınladığını düşün. Sayfa sunucuda çalışıyor ve kullanıcılar doğrudan URL’yi açabiliyor. Bu yalnızca URL’nin mevcut olduğunu gösterir.
Daha sonra bu yazıya mevcut bir içerikten internal link verdin:
MEVCUT YAZI
↓
INTERNAL LINK
↓
YENİ YAZI
Googlebot mevcut sayfayı tekrar crawl ettiğinde yeni bağlantıyı görerek URL’yi keşfedebilir. Ardından sistem yeni URL’yi crawl etmeye karar verirse Googlebot sayfaya erişir ve içeriği alır. Bundan sonraki indexing kararı ise artık başka bir aşamadır.
PUBLISHED
↓
DISCOVERED
↓
CRAWLED
↓
?

INDEXING NEXT
Crawling kavramının özü bu kadar: crawler’ın bildiği URL’ye erişip içeriği getirmesi.
Mini uygulama
Herhangi bir web sitesinde yeni veya nispeten derin bir sayfa seç. Ana sayfadan başlayarak bu URL’ye yalnız bağlantıları takip ederek ulaşmaya çalış.
Ardından şu üç soruya cevap ver:
- URL’ye kaç bağlantı adımında ulaştın?
- Sayfaya hangi başka sayfalar link veriyor?
- Bir crawler’ın bu URL’yi keşfetmesini sağlayacak açık bir yol görebiliyor musun?
Bu uygulamanın amacı henüz crawling audit yapmak değil. Amaç bir crawler’ın web’i URL ve bağlantı ilişkileri üzerinden nasıl keşfedebildiğini gözlemlemek.
Bu dersi anladıysan şunları açıklayabilmelisin
- Crawling nedir?
- Googlebot’un görevi nedir?
- Discovery ile crawling neden aynı şey değildir?
- Crawl edilen bir sayfa neden otomatik olarak indexlenmiş sayılmaz?
- Internal linkler URL discovery’ye nasıl yardımcı olabilir?
- XML sitemap neden crawling garantisi değildir?
- Crawling ile crawlability arasındaki fark nedir?
SEO 101’de sıradaki
Indexing Nedir? Crawler’ın URL’yi nasıl keşfedip içeriğe eriştiğini gördük. Bir sonraki derste crawl edilen içeriğin nasıl işlendiğini, Search index kavramını ve Indexable ≠ Indexed ayrımını inceleyeceğiz.
Derin okuma
- Arama Motorları Nasıl Çalışır? Tarama, İndeksleme, Retrieval ve Sıralama
- Crawlability ve Indexability Nedir? Aralarındaki Fark Nedir?
Kaynaklar ve teknik referanslar
- Google Search Central — In-depth Guide to How Google Search Works
- Google Search Central — Crawling and Indexing Documentation
- Google Search Central — Learn About Sitemaps
İlgili yazılar
URL Nedir? SEO İçin URL Yapısı Nasıl Olmalı?
SEO 101 · ON-PAGE SEOSEVİYE: BEGINNER URL, internetteki bir kaynağın adresidir. Bir web sayfası, görsel veya başka bir kaynak tarayıcı…
H1 Nedir? H1 Etiketi SEO’da Nasıl Kullanılır?
SEO 101 · ON-PAGE SEOSEVİYE: BEGINNER H1, bir web sayfasının ana içerik başlığıdır. HTML’de <h1> etiketiyle tanımlanır ve kullanıcıya sayfanın…
Meta Description Nedir? SEO Açıklaması Nasıl Yazılır?
SEO 101 · ON-PAGE SEOSEVİYE: BEGINNER Meta description, bir web sayfasının içeriğini kısa biçimde açıklamak için kullanılan HTML metadata alanıdır.…
Organik kanalı beraber büyütelim.
Sitenizi anlatın; veriye bakıp uygun olup olmadığımızı açıkça söyleyeyim. Uygunsa 30 dakikalık görüşme ayarlarız.